这款产品老黄在 2025 年的 CES 大会宣布的时候,我就注意到了,当时它还叫 Project DIGITS。
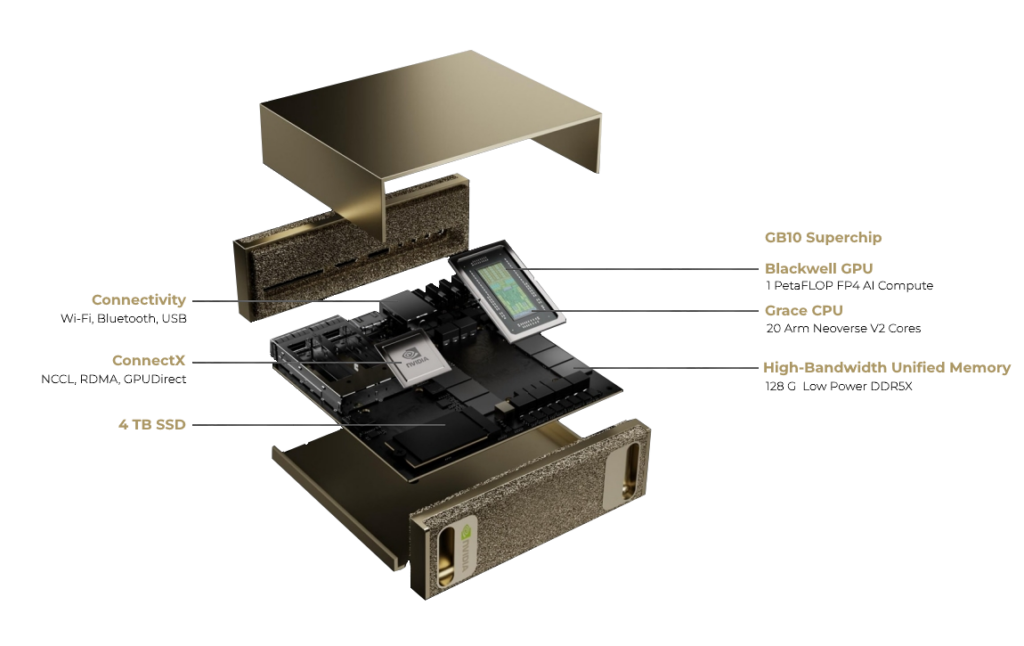
它内含一颗 ARM 架构的 GB10 Grace Blackwell 芯片。宣称有 1 PFLOPS(千万亿次浮点运算/秒)的 FP4 精度计算能力 官方的 1 PFLOP 是启用结构化稀疏特性时的理论 FP4 峰值,并不等同于本文模型实际可获得的 dense 推理算力。。搭配 128 GB 的统一内存和 ConnectX-7 200Gb/s 的高速网络多机拓展网卡。这个纸面数据让人感觉能在本地部署千亿级参数大模型。
最近有个机会能体验到这个产品,实际测试了这台 DGX Spark 的推理性能。
DGX Spark 的瓶颈
128G LPDDR5x 统一内存可以说是 DGX Spark 最吸引人的地方了。类似 Apple Silicon M 系列的统一内存架构,CPU 和 GPU 可以共享这一块内存。这让大几十 GB 的模型本地部署成为了可能。
但是这又存在一个很明显的限制:这个内存是 256 位宽的 LPDDR5x,带宽只有 273GB/s。相比之下,GeForce RTX 5090 的 32G GDDR7 显存带宽可以达到 1,792GB/s,大约是它的 6.6 倍。
内存带宽的瓶颈会限制大模型在 Decoding 阶段的性能。对于自回归语言模型的推理,可以分为 Prefilling(并行处理输入的 内容,将文本转换为模型可以处理的格式)和 Decoding(模型根据已有上下文生成输出)两个阶段。
Prefilling 阶段的内容是已知的,那么可以受益于 Transformer 架构的并行优势。所以 Prefilling 阶段主要是 Compute Bound(计算受限)。
而通常的 Decoding 是自回归的,模型每生成一个 token,就需要将这个 token 作为输入再次送入模型进行下一步的推理。同一条序列的下一步依赖上一步的结果,不能像处理输入那样一次并行处理所有位置,不过每一步内部的 GPU 计算仍然可以并行。对于单请求、小批量的推理,反复读取模型权重和 KV cache 的开销很突出,往往是 memory-bandwidth-bound(内存带宽受限)。这时 DGX Spark 的内存带宽就会成为瓶颈。
部署环境
我们先回到这台 DGX Spark 的软件栈。它的操作系统是 Ubuntu 24.04 LTS,内核版本是 6.17.0-1021-nvidia。已经预装好了驱动和 CUDA 开发环境,Docker 和 NVIDIA Container Toolkit(CUDA 版本是 13.0,驱动版本 580.159.03)
英伟达的 DGX 和 Jetson 系列产品的官方镜像都预装并配置好这些软件栈,这点很方便。DGX Spark 机器我并没有接触实机,而是通过远程的方式访问的。。拉取 nvcr.io/nvidia/cuda:13.0.1-devel-ubuntu24.04 镜像后运行 nvidia-smi,就可以看到 GPU 的信息了。
至于推理框架,我之前在个人设备上会选择轻量的方案,比如 PC 上会直接用 llama.cpp (LM Studio),Mac 上使用过 MLX 和 Ollama。这类工具本地部署更便利,兼容也更强。例如,llama.cpp 考虑了个人设备没有专业显卡,可以 CPU 和 GPU 之间部署模型,在显存不足时仍能利用系统内存运行较大的模型;MLX 则针对 Apple Silicon 的统一内存架构进行了优化。LM Studio 和 Ollama 又进一步简化了模型下载、配置和 API 服务。
但如果是多用户部署场景 ,为了满足更高的性能和并发需求,则需要考虑并发的请求,KV 缓存,利用率。vLLM 和 SGLang 在这些方面功能更全面 提供 continuous batching、prefix caching 和 speculative decoding 等推理优化。我最终选择了 vLLM。除了较成熟的模型和部署生态外,它已经支持 AWQ、FP8、MXFP4 和 NVIDIA NVFP4 等多种量化格式,并提供多种推理优化。对于多模态生成,vLLM 项目还率先发展出了 vLLM-Omni,将推理服务扩展到图像、语音和视频等模型,类似的 API 方便我未来部署其他模态模型。
vLLM 本身就提供了 Docker 镜像,其他针对硬件调优过的镜像也有。eugr/spark-vllm 镜像是一个不错的选择。它本身就基于 DGX Spark 调优。而且支持 recipe 的方式来配置模型和推理参数。这个镜像我会在后续的测试中使用。
模型选择
讨论模型的选择,我有两个要求:一是模型要能在设备上运行,二是模型足够智能。根据 Artificial Analysis 的评分,目前开源模型最高能做到 46 分(Xiaomi MiMo 2.6 Pro),但这个等级的模型都太大了(1T 以上参数量)。相对比较合理的是 20-40 分区间的模型,主要是千问家族的模型。这些模型里面也主要有两种类型:稠密模型(Dense Model)和稀疏的混合专家模型(Mixture-of-Experts, MoE)。
其中稠密模型是指所有的参数都参与计算的模型。运行时模型的参数要能够全部加载到运行内存中,所以硬件的内存/显存要足够大。具体模型代表是 Qwen3.8-27B。
稀疏的混合专家模型则是指在推理时,只有部分专家(Expert)参与计算。MoE 将部分网络层划分为多个 Expert,推理时每个 token 只路由到其中少数 Expert。MoE 模型的参数量可以非常大,但每个 token 只会激活其中的一部分专家,从而减少这一步的计算量和需要读取的专家权重。未激活的专家仍然需要存储,不能按激活参数量估算整个模型的内存需求。具体模型代表是 Qwen3.8-Flash-Next(180B 参数 6B 激活);Qwen3.6-35B-A3B (35B 参数 3B 激活)。
对应 DGX Spark 的硬件,这个规模的量化稠密模型能够放进 128G 的统一内存,但是 Decoding 阶段仍然可能受到内存带宽的限制。而 MoE 模型如果能装进去,每个 token 需要读取的专家权重较少,我也更期待它在这台机器上的速度。具体能快多少,还需要看模型结构、推理后端和实际配置。那么这三个模型就是我这次尝试的对象了。
| 模型 | 总参数量 | 激活参数量 | Checkpoint 分片大小 | 加载阶段内存计数1 | AAII2 |
|---|---|---|---|---|---|
| Qwen3.8-27B | 27B | 27B | 20.42 GiB | 23.53 GiB | 343 |
| Qwen3.8-Flash-Next | ≈180B4 | 6B5 | 98.57 GiB | 73.74 GiB6 | 40 |
| Qwen3.6-35B-A3B | 35B | 3B | 21.82 GiB | 21.97 GiB | 18 |
1. 内存计数来自 vLLM 的
Model loading took … GiB memory日志,统计加载区间内 PyTorch allocated 内存的变化;加载区间也包含投机解码所需模型的加载。它不是纯主模型权重大小,也不是进程或整机总占用。分片大小来自本机缓存检查,内存计数来自对应的启动日志。1 GiB = 2³⁰ bytes。
2. AAII 为 Artificial Analysis Intelligence Index,版本 v4.3.2。
3. Qwen3.8-27B 的 34 分对应xhigh思维强度。
4. Qwen3.8-Flash-Next 总参数约 180B,包括 125B MoE、51B n-gram embedding 和 4B MTP 参数。
5. 6B 指主 MoE 模型每个 token 的激活参数量,不包括 n-gram embedding 和 MTP。
6. Flash-Next 启用了 PLE/n-gram table 的磁盘 offload,后文会展开。三个 checkpoint 都以 NVFP4 命名,但这不代表所有张量都以 FP4 存储或计算。
运行模型
Recipe 和启动配置
eugr/spark-vllm 镜像可以直接使用 recipe 的方式来配置模型和推理参数。
Recipe 里面已经写好了模型地址、容器镜像、环境变量和 vllm serve 参数。三个模型的 tensor parallel size 都设为 1,上下文上限设为 262144,最多同时调度 4 条序列,每批 token 预算是 4096,KV cache 使用 FP8,内存比例设为 0.8。
以 Qwen3.6 为例,启动时的主要参数如下:
--tensor-parallel-size 1
--max-model-len 262144
--max-num-seqs 4
--max-num-batched-tokens 4096
--gpu-memory-utilization 0.8
--kv-cache-dtype fp8
--enable-chunked-prefill
--no-async-scheduling
--enable-prefix-caching
--speculative-config '{"method":"mtp","num_speculative_tokens":3,"moe_backend":"triton"}'
三个模型共享相同的服务级参数;加载和推理方式则按照各自的架构和 recipe 配置如下:
| 项目 | Qwen3.8-27B | Qwen3.6-35B-A3B | Qwen3.8-Flash-Next |
|---|---|---|---|
| Checkpoint | nvidia/Qwen3.8-27B-NVFP4 | nvidia/Qwen3.6-35B-A3B-NVFP4 | local-inference-lab/Qwen3.8-Flash-Next-NVFP4 |
| 镜像 | 普通 spark-vllm | 普通 spark-vllm | spark-vllm-b12x |
| 加载方式 | instanttensor | fastsafetensors | b12x |
| 投机解码 | DFlash2,8 tokens | MTP,3 tokens | MTP,4 tokens |
| 特殊设置 | 独立 DFlash2 draft model | 主 MoE 使用 Marlin,draft MoE 使用 Triton | PLE table 磁盘 offload,Mamba cache 使用 align |
投机解码:MTP 和 DFlash2
三个模型都开启了投机解码 Speculative Decoding,通过提前预测候选 token 并交给主模型验证,提升生成速度。。通常,主模型每计算一次,只生成一个 token。投机解码先让规模较小的近似模型,或主模型自带的预测模块,预测接下来几个 token,再交给主模型一起检查。如果预测正确,主模型一次就能确认多个 token,不用每生成一个 token 都重新读取一遍权重、完成一轮计算。对于内存带宽有限、同时处理的请求较少的情况,这有机会明显缩短生成时间。
主模型的检查也有具体规则。如果设置为每次选择概率最高的 token,候选就必须与主模型的选择一致;如果按概率随机选择,则需要根据两个模型给出的概率决定是否接受候选,并在拒绝时修正,保证最终结果仍遵循主模型的概率分布。遇到不被接受的候选,就从那个位置重新生成。能快多少,要看预测正确的 token 有多少,以及预测和检查本身花了多少时间;如果经常猜错,反而可能比直接让主模型生成更慢。
这次实验根据模型的架构,有两种投机解码的实现:MTP Multi-Token Prediction。 使用主模型自带的预测模块,需要模型和推理引擎支持;DFlash2 则使用针对主模型训练的独立小型近似模型,需要额外加载它的权重。这次 Qwen3.6 和 Flash-Next 使用 MTP,每轮分别预测 3 和 4 个候选 token;27B 使用 DFlash2,设为 8 个。相关介绍可以参考 vLLM 的 MTP 文档和 DFlash2 的作者介绍。
vLLM、B12X
前文介绍不同模型配置有提到我们使用到了 spark-vllm 和 spark-vllm-b12x 两种镜像。它们都基于 vLLM 构建,但针对不同的硬件和需求进行了定制。
B12X 本身是面向 DGX Spark、RTX Spark 和相关 Blackwell 显卡的 CuTe DSL/Triton 算子库,包含量化矩阵乘法、MoE 等推理组件,也有可选的 checkpoint loader。硬件专用的算子有机会改善这些架构上的效率,并较早支持新模型的计算。对 Qwen 3.8 Flash-Next 而言,B12X 组合还提供了所需的模型组件和从磁盘读取 PLE 表的功能。
Flash-Next 的磁盘 offload 和启动时间
Flash-Next 的情况稍微复杂一些。它的 checkpoint 分片接近 100 GiB,如果全部放进内存,留给缓存和其他运行时开销的空间就很有限。启动脚本设置了 VLLM_PLE_TABLE_MEMORY=disk,将 PLE/n-gram table
Per-Layer Embedding。 保留在 NVMe 上,推理时再按需读取。
PLE 通过当前位置附近的短 n-gram(如 bigram 和 trigram)计算哈希索引,从预训练的 embedding table 中读取向量,并注入当前 token 的内部表示,为模型提供额外的局部模式信息。将这些表留在磁盘可以腾出更多内存给 KV cache 和其他运行时状态,查表则由 NVMe 按需承担。因此,这种 offload 用存储 I/O 换取了更大的可部署模型空间。
关于模型的启动时间,运行日志显示 Qwen3.6 约用了 103 秒,27B 约 374 秒,Flash-Next 约 198 秒。其中模型加载分别约为 26、19 和 53 秒,其余时间主要用于编译、图捕获和引擎初始化。27B 最能体现这种差异:权重加载约 19 秒,而完整服务启动约 374 秒。
内存和缓存
模型权重能放进内存,只是运行模型的第一步。推理时还需要保存上下文的 KV cache,以及中间张量、CUDA Graph 和其他运行时状态。对于普通的 Transformer Attention,KV cache 保存的是每层已经计算过的 Key 和 Value;生成下一个 token 时,可以直接读取这些状态,不必重新计算前面所有 token 的 K、V,但仍然需要进行当前 token 的 Attention 计算。
KV cache 的容量主要随上下文长度、并发序列数、层数、KV head 数、head dimension 和存储精度增长。对于常规的全注意力模型,可以粗略理解为「2 × 层数 × KV head 数 × head dimension × 已缓存 token 数 × 每个元素的字节数」。
这也是权重量化和缓存量化需要分开看的原因。权重使用 NVFP4,并不代表 KV cache 也是 FP4。这次三个模型都使用 FP8 KV cache:相对于 FP16/BF16,K、V 张量本身每个元素的存储从 2 bytes 降为 1 byte,可以为更长的上下文和更多并发留出空间。
DGX Spark 上,在前文这几套 recipe、--gpu-memory-utilization 0.8 和 FP8 KV cache 的配置下,启动日志给出的可用 KV cache 内存预算如下:
| 模型 | 可用 KV cache 预算 |
|---|---|
| Qwen3.6-35B-A3B | 67.03 GiB |
| Qwen3.8-27B | 64.73 GiB |
| Qwen3.8-Flash-Next | 17.33 GiB |
两个较小的模型都能给缓存留下约 65 GiB;通过将 PLE/n-gram table offload 到磁盘,Flash-Next 在约 180B 的总参数规模下仍保留了 17.33 GiB 的 KV cache 预算。
KV cache 分块
vLLM 用 PagedAttention 的方式管理 KV cache,将序列的缓存分成固定 token 数的 block,这样不需要提前为每条请求分配一整块最大上下文长度的连续空间。
缓存匹配看的是从开头连续一致的 token 序列,而不是两段文字语义相近。vLLM 的前缀缓存哈希包含当前块的 token、前面块的哈希,以及必要的额外标识。因此,即使某一块文字相同,只要之前的上下文不同,也不能直接复用该块的状态。System prompt、chat template、工具定义和消息顺序都会影响最终的 token 前缀;把固定说明放在前面、把时间戳和本次问题放在后面,通常更有利于复用。相关机制见 vLLM 的 Prefix Caching 设计文档。
对于普通的全注意力、单一块大小配置,缓存会以完整块为单位复用。假设两个请求共享前 100 个 token,且这些块都还保留在缓存里,那么块大小为 16 时,按边界最多能复用 96 个 token(16 * 6);块大小为 64 时则只有 64 个。小的缓存块可以提升缓存命中率。不过,相同长度会对应更多块,增加哈希、块表和分配管理的开销。
实际测试
我这次更关心三个问题:短输入时生成有多快,输入变长以后要等多久,以及几个人同时发请求时,整台机器能处理多少输出。
客户端直接访问本机的 loopback 地址,测量的是本机推理服务的响应。输入是合成的重复英文材料,用每个模型自己的 tokenizer 补齐长度,包含 chat template 的开销。比较口径是相同输入 token 数下的响应时间、生成速度和吞吐。
每条请求固定输出 1024 tokens,temperature=0、ignore_eos=true,并在请求里设置 enable_thinking=false。每个输入长度分别测试并发 1、2、4,每个模型在每种输入长度与并发组合下重复测量三次,每次测量的并发请求同步提交。三个模型统一比较 2K、8K、32K 和近 64K;长上下文扩展测试进一步覆盖 Qwen3.6 的 128K 三档并发和近 262K 单请求。
下面用一张分组点图比较三个模型。每个横向区域对应一个输入长度,横轴为所选指标的实测值;颜色区分模型,圆形、方形、三角形分别表示客户端并发 1、2、4。每组的纵向位置表示单请求 decode 生成速度,越高越快;右侧统一使用 0–200 tok/s 刻度,不同输入长度之间也可直接比较点的高度;同一输入长度、同一模型的并发 1 → 2 → 4 用细线连接,便于看出并发增加后的变化。数值为三轮均值,悬停可以查看范围;下拉框可以切换横轴指标和横轴的对数/线性刻度,纵向始终表示 decode 生成速度。
上下文长度与并发性能
单台 DGX Spark· 输出 1024 tokens · 无前缀复用
正在读取实测数据。
点击图例可显示或隐藏模型、并发设置;两组筛选共同生效。
数值为三轮的算术平均。64K / 262K 档实际输入为 64512 / 261120 tokens。
先看单请求的短输入。2K 时,Qwen3.6 的平均 decode 速度约为 171 tok/s,27B 约 79 tok/s,Flash-Next 约 56 tok/s。在我测试的这几套配置里,35B-A3B 的平均生成速度分别约为另外两个模型的 2.2 和 3.0 倍,平均首个文本等待约 0.35 秒,生成完 1024 tokens 约需 6.35 秒。
并发增加以后,在 2K 上下文、并发 4 时,Qwen3.6 每条请求平均约 124 tok/s,整轮输出吞吐约 454 tok/s;27B 分别约为 50 和 180 tok/s。在短上下文下,DGX Spark 能承接多个请求并行时的计算需求:Qwen3.6 的并发从 1 增加到 4,单请求生成速度从约 171 降到 124 tok/s,整机输出吞吐则从约 161 提高到 454 tok/s,达到约 2.8 倍。
输入变长以后,性能变化主要开始体现在首文本等待和整轮吞吐上。近 64K、单请求时,Qwen3.6 等到首个文本平均约需 14.6 秒,27B 约 36.8 秒,Flash-Next 约 27.3 秒。到并发 4,等待分别增加到约 37.7、94.7 和 71.8 秒。整轮输出吞吐也随输入变长而下降。单请求下,从 2K 增加到近 64K,Qwen3.6 的吞吐从约 161 降到 47.2 tok/s,27B 从约 75.1 降到 20.1 tok/s,Flash-Next 从约 51.7 降到 24.7 tok/s,降幅分别约为 71%、73% 和 52%。27B 与 Qwen3.6 的相对降幅接近,但近 64K 时,Qwen3.6 的吞吐仍分别约为另外两个模型的 2.3 和 1.9 倍。并发 4 时,三个模型的吞吐分别约为 56.9、23.8 和 25.8 tok/s。对 Qwen3.6 来说,并发从 1 增加到 4,在 2K 下带来约 2.8 倍的吞吐,在近 64K 下则为约 1.2 倍:长输入下,系统性能逐渐由 Prefill 和首文本等待主导,并发对输出吞吐的提升也相应减弱。
在更长上下文的场景下,Prefill 所在的输入处理阶段会占用更多时间,而开始输出后的解码仍能保持较高速度。Qwen3.6 在近 64K、128K 和近 262K 的单请求测试中,平均首文本等待分别约为 14.6、44.2 和 144.7 秒,decode 速度则分别约为 144、128 和 100 tok/s。输入长度扩大约四倍后,首文本等待增长到约十倍,解码速度仍保留约七成;长上下文对响应时间的影响主要体现在开始输出之前。近 262K 的三次请求都完成了 1024 tokens 输出,展示了单台机器处理接近完整 262K 上下文并持续生成的能力。
再看相同输入重复提交的效果。缓存测试单独画成气泡图,横轴是三个模型,纵轴是 TTFT,气泡面积代表 decode 速度。每个模型的三个气泡对应首次请求与后面两次重复,可以同时看到等待时间的下降和生成速度的变化。Qwen3.6 首次 TTFT 约 1.094 秒,后两次约 0.534 和 0.529 秒,各命中 4288 tokens;27B 从约 3.086 秒降到 1.286 和 1.288 秒,各命中 4944 tokens;Flash-Next 从约 3.472 秒降到 1.188 和 1.193 秒,各命中 6048 tokens。这三组顺序请求都观察到了输入前缀复用,后两次请求的平均首文本等待相对各自首次请求分别缩短约 51%、58% 和 66%。
前缀缓存复用性能
8192 tokens 输入 · 1024 tokens 输出 · 顺序请求三次 · 服务保持前缀缓存开启
正在读取缓存实验数据。
① 首次 ② 重复 1 ③ 重复 2 · 箭头表示请求顺序
气泡面积 ∝ decode TPS
越低表示首个文本等待越短,气泡越大表示 decode 越快。气泡面积与 TPS 成正比;同一模型内横向略微错开,只用于区分请求顺序。
每个气泡是一次请求。第二、三次与同组首次请求比较;悬停或点击可查看命中 tokens 与延迟变化。
原始数据获取请前往 GitHub Gist。
结语
至此,DGX Spark 性能算是比较清楚了。128 GB 统一内存能提供足够的空间来运行千亿级的模型(Qwen 3.8 Flash Next),并且在 64K 上下文下仍能保持约 70 tok/s 的解码速度。对于单用户场景,这样的响应和生成速度已经能够支撑本地编程、写作和问答等交互式任务。对于多用户场景,短上下文下整机输出吞吐可以达到约 454 tok/s,能够支撑少量用户共享的文档处理和问答服务。
在这几套部署配置中,Qwen3.6-35B-A3B 提供了最好的响应与吞吐表现。上下文变长后,响应时间主要增长在开始输出之前,单请求解码仍保持约 100–144 tok/s。应该也会选择它会作为这台机器后续部署的主要模型。